Documentació que arribava per tots els canals
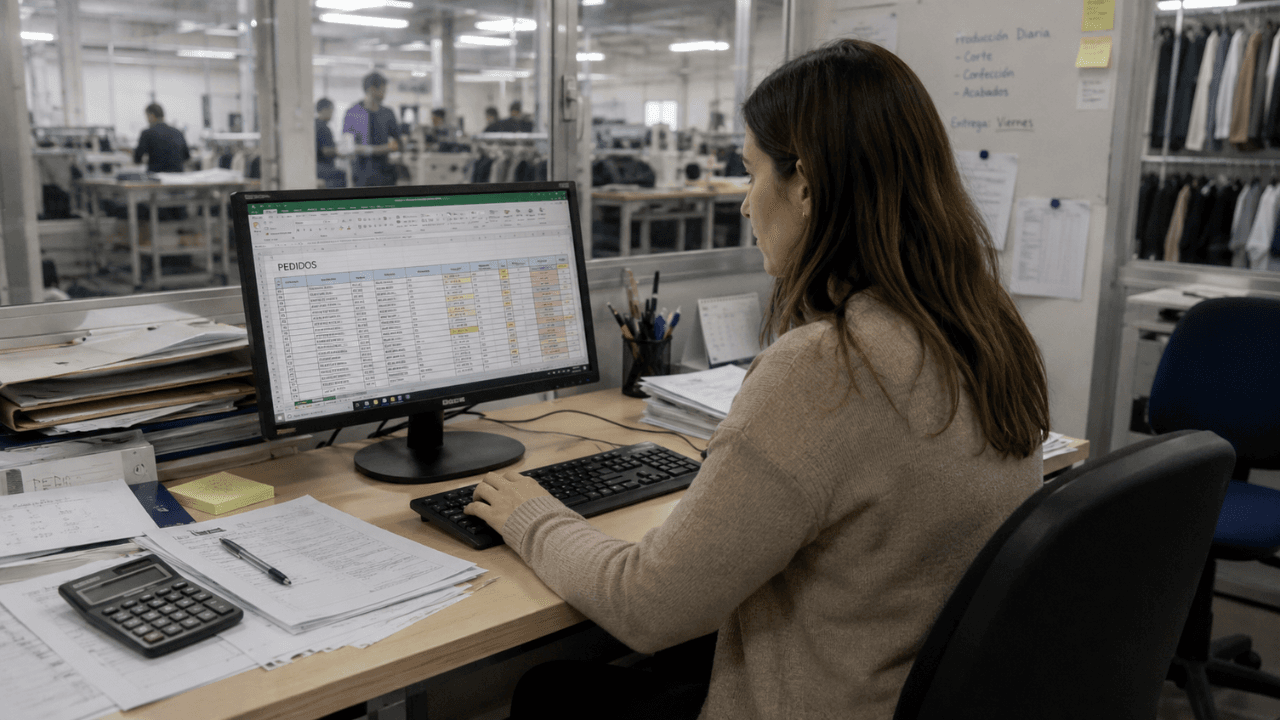
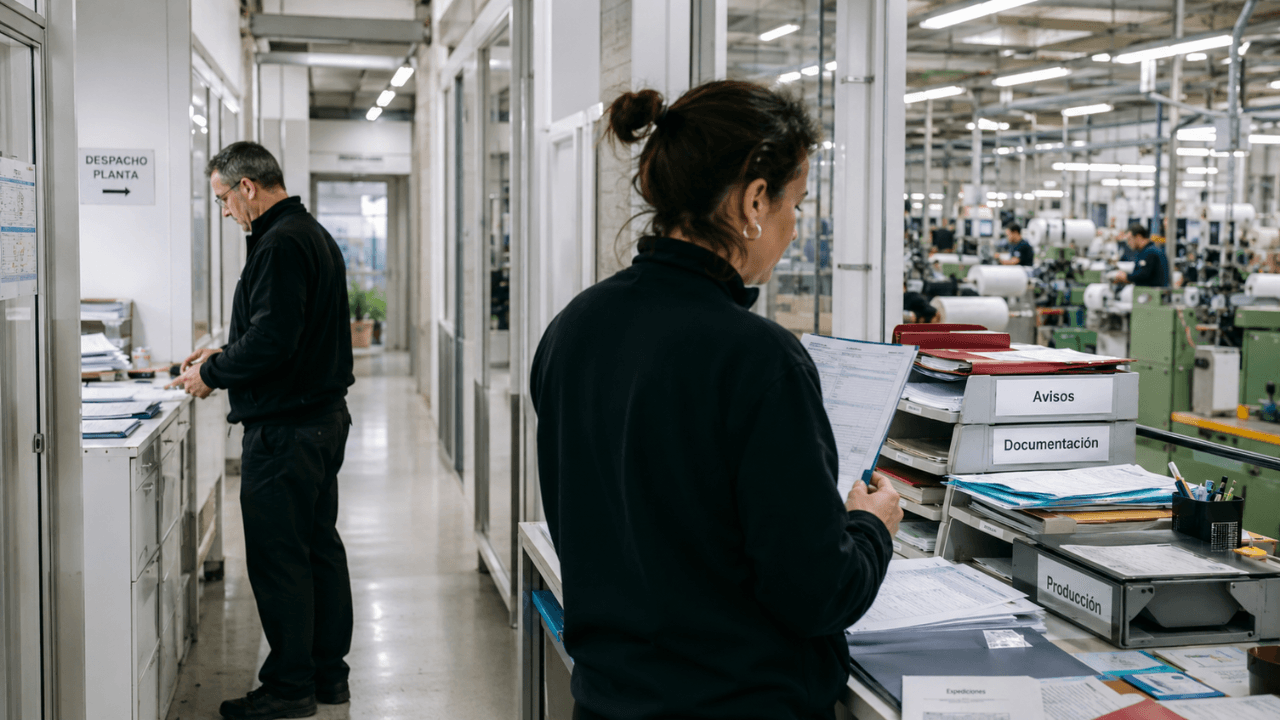
Una empresa industrial catalana, amb seu a l'àrea de Barcelona, rebia cada dia un flux constant de documentació: albarans de proveïdor, certificats de material, comandes de clients en formats distints i consultes internes sobre terminis i referències. Part arribava escanejada, part per correu i una altra per portals B2B amb adjunts heterogenis. L'equip administratiu classificava i derivava cada document a mà abans que pogués impactar en compres, planificació o facturació.
La direcció no buscava substituir processos productius consolidats. L'objectiu era reduir treball repetitiu a back-office i evitar que consultes freqüents (estoc d'una referència, estat d'una comanda, historial amb un proveïdor) depenguessin sempre d'interrompre la mateixa persona que sap on està arxivat tot. La intel·ligència artificial va aparèixer com a eina possible per a classificació i extracció sobre documents i historial intern ja existent.
El treball d'obrir, llegir i arxivar
El coll d'ampolla principal estava a l'entrada i classificació de documents. Cada albarà o comanda requeria identificar tipus, client o proveïdor, referències implicades i departament destí abans de qualsevol acció al sistema. Els formats variaven: PDF escanejat, fulls de càlcul amb columnes distintes segons l'emissor, imatges enviades per missatgeria instantània. Els errors de classificació provocaven retards difícils de detectar fins que algú demanava la peça documental en una revisió de qualitat o en una auditoria interna.
Consultes que interrompien el mateix perfil
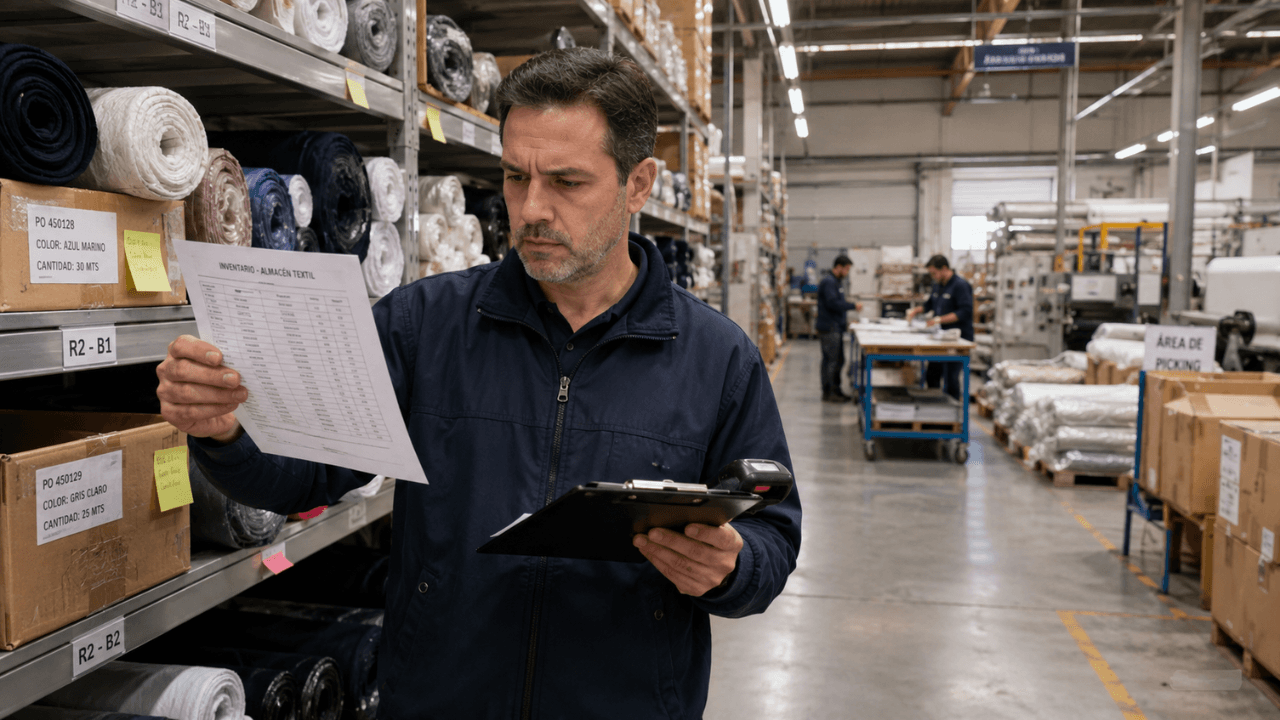
Operaris, comercials i responsables de planta preguntaven el mateix amb redacció diferent: disponibilitat de material, data prevista d'entrega, ubicació d'un document signat. Respondre exigia consultar diversos sistemes o preguntar a qui portava la dada al cap. No es tractava de falta d'informació, sinó de fricció en accedir-hi. La companyia necessitava automatitzar tasques de baix valor afegit sense tocar la lògica central de fabricació.
Cues al tancament del dia i decisions amb informació incompleta
Documents pendents de classificar formaven cues al final del dia; compres alliberava comandes amb retard perquè l'albarà encara no estava registrat; planificació consultava estoc mentre administració encara digitalitzava entrades del mateix material. En pics d'activitat (tancament de mes, recepció de contenidors, campanyes comercials) el retard documental es traduïa en urgències i reprocesos. El cost es manifestava en hores extra, tensions entre departaments i decisions preses amb informació incompleta.
La dependència de persones expertes en on buscar limitava l'autonomia de la resta de l'equip. Noves incorporacions trigaven setmanes a entendre la lògica informal d'arxius i excepcions. Ampliar plantilla només per moure papers i respondre preguntes recurrents no era sostenible.
Un projecte petit i ben delimitat
Es va dissenyar un projecte acotat d'automatització amb intel·ligència artificial aplicada a un sol front: classificació i encaminament de documents entrants. Res de robots en línia ni prediccions sobre demanda; només reduir el treball d'obrir, llegir i arxivar. La solució es va desplegar en infraestructura controlada, amb regles clares del que es podia automatitzar i del que requeria validació humana.
Entrenament amb documents propis
Un model entrenat amb exemples reals anonimitzats va aprendre a reconèixer tipus de document (albarà, comanda, certificat, avís de modificació) i a extreure camps clau com referència, quantitat, proveïdor o número de lot. Un operari revisa i confirma en segons en lloc de teclejar des de zero. Quan la confiança del sistema és alta, el registre pot completar-se de forma automàtica; en casos ambigus, la decisió queda pendent de revisió explícita.
Després dels primers mesos d'ús estable, l'empresa va reduir de forma significativa el temps mitjà de classificació. Les cues al tancament del dia van disminuir i compres va poder alliberar entrades de material amb major celeritat. L'equip va valorar la revisió assistida: confirmar propostes ja estructurades en lloc d'interpretar cada PDF des de zero. La direcció va obtenir mètriques clares (documents processats per dia, taxa d'encert, casos amb revisió manual) per decidir ampliacions futures amb criteri.